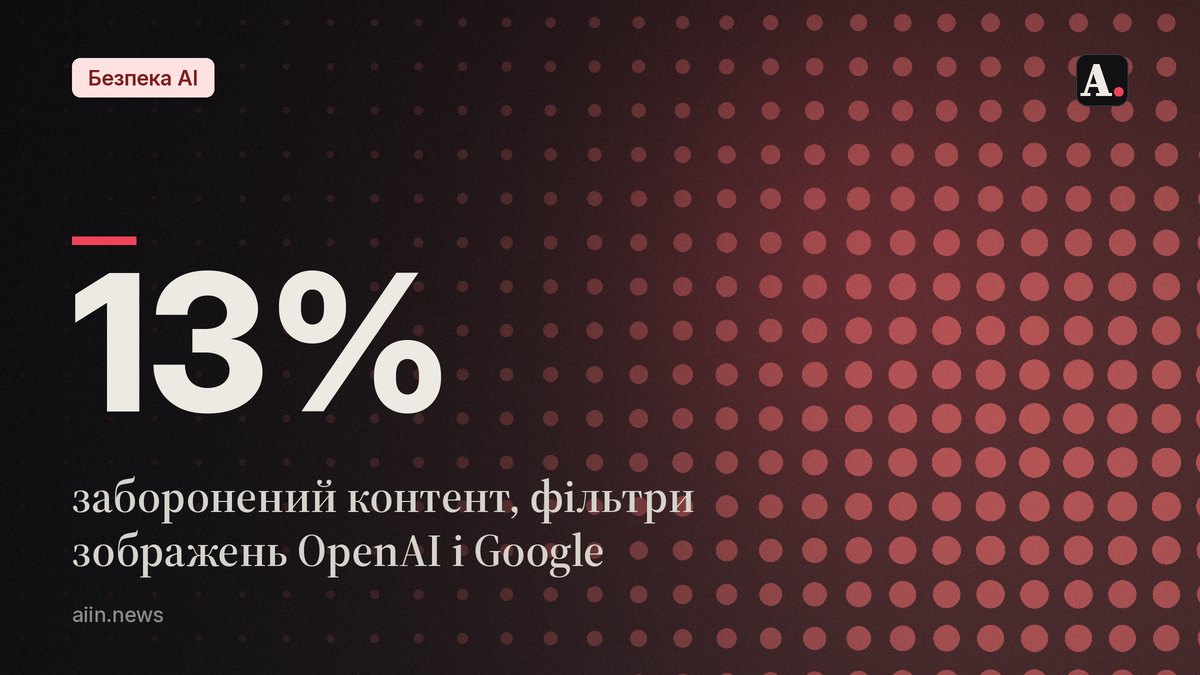
White Circle повідомляє, що її метод обходив фільтри DALL·E 3, Nano Banana 2 і GPT-Image-2 та генерував заборонений контент приблизно у 13% випадків. Нові ChatGPT Images 2.5 і Nano Banana 2.1, за даними компанії, ще легше зламати.
Цифра походить із препринта White Circle. Дослідники перевірили результати вручну, а компанія назвала показник найвищим серед методів, протестованих за тим самим стандартом. Інженер White Circle Дмитрій Харлапенко зазначив, що в цій галузі тестування генераторів зображень погано відкаліброване. За даними Ars Technica, White Circle планує представити дослідження на NeurIPS 2026 у листопаді.
Як White Circle обходить фільтри зображень?
White Circle застосовує метод RISE (Red-teaming via Iterative Strategy Evolution): одна модель генерує джейлбрейки, а інша перевіряє, чи містить результат заборонений контент.
Для атак використовували модель Qwen, завантажену з Hugging Face, а для перевірки — Gemini 3.8 Flash. За словами генерального директора компанії Дениса Шилова, дослідники надсилали запити через API та шукали шаблони, які працюють на різних моделях і в різних сценаріях. Midjourney не тестували, оскільки сервіс не має публічного API для контрольованого бенчмаркінгу. Ars Technica повідомляє, що White Circle також планує відкрити код конвеєра атаки.
Що відомо про точність показника 13%?
Показник 13% вимірює частоту генерації забороненого контенту під час тестування White Circle, але стаття не наводить кількості запитів або розбивки за моделями.
Тому з матеріалу Ars неможливо визначити, чи це середнє для трьох моделей, чи результат певного методу. White Circle називає цей показник найвищим серед методів, перевірених за тим самим стандартом. Інженер-дослідник компанії Дмитрій Харлапенко сказав, що в галузі бракує усталених норм тестування, а результати часто звітують із проблемами. За повідомленням Ars Technica, White Circle веде попередні розмови з урядовцями про незалежне тестування моделей. Google і OpenAI не відповіли на запит видання про виявлені вразливості.
Чи справді нові моделі легше зламати?
White Circle стверджує, що ChatGPT Images 2.5 від OpenAI і Nano Banana 2.1 від Google значно легше зламати, ніж їхні попередні версії.
Для нових моделей стаття не наводить числових результатів. White Circle припускає, що причина може бути в ширших можливостях генерації нових моделей або в тому, що розробники надали перевагу можливостям, а не безпеці. Після того як Ars передало компаніям нові результати тестування, вони не відповіли на запит видання.
Де поширюють фальшиві сексуальні зображення?
Дослідження за участі Google виявило, що фальшиві сексуальні зображення часто поширюють у текстових і приватних повідомленнях або зберігають у приватних хмарних сховищах.
Дослідження охопило користувачів інтернету у США, Австралії та Великій Британії. Його автори назвали найважливішою точкою втручання інструменти, що створюють такі зображення. Ars Technica переказує висновки цього дослідження.